过去一年,问“要不要加结构化数据”的人少了,问“为什么加了没用”的人多了。这两个问题的答案并不在同一个层面:前者问的是要不要做,后者问的是做对没有。绝大多数“加了没用”的情况,问题都不在 JSON-LD 本身,而在标注和正文各说各话。
一、它解决什么,不解决什么
结构化数据是一套写给机器看的注释。用 Schema.org 的词汇表,以 JSON-LD 的格式写在页面里,告诉检索侧:这一段是组织信息,这一条是问答对,这一页属于哪个栏目、发布于哪一天。它不改变用户看到的页面,只改变机器对页面的理解。
它能解决三件具体的事。一是实体是谁——同名公司、简称与全称混用、公众号用别名,这些问题靠自然语言很难消歧,靠一个固定的实体标识却能收敛。二是这段话归谁——内容被转载、被摘编、被摘成短句之后,源头归属容易丢失,标注是留一个可追溯的锚点。三是这条问答成不成对——问题与答案的对应关系,自然语言里要靠上下文推断,标注里是一对明确的键值。
它不能解决的事同样清楚:正文没有的内容,标注写上去也不会被采信;页面打不开、正文靠脚本渲染,标注同样读不到;它不会让你排到前面。把结构化数据当成排名手段,是这类投入最常见的错位——做了很多,方向从一开始就偏了。
二、先标这四段就够用
站点内容一多,很容易陷入“全部标一遍”的冲动。按被引用概率和维护成本排,先做下面四类,投入产出比最高。
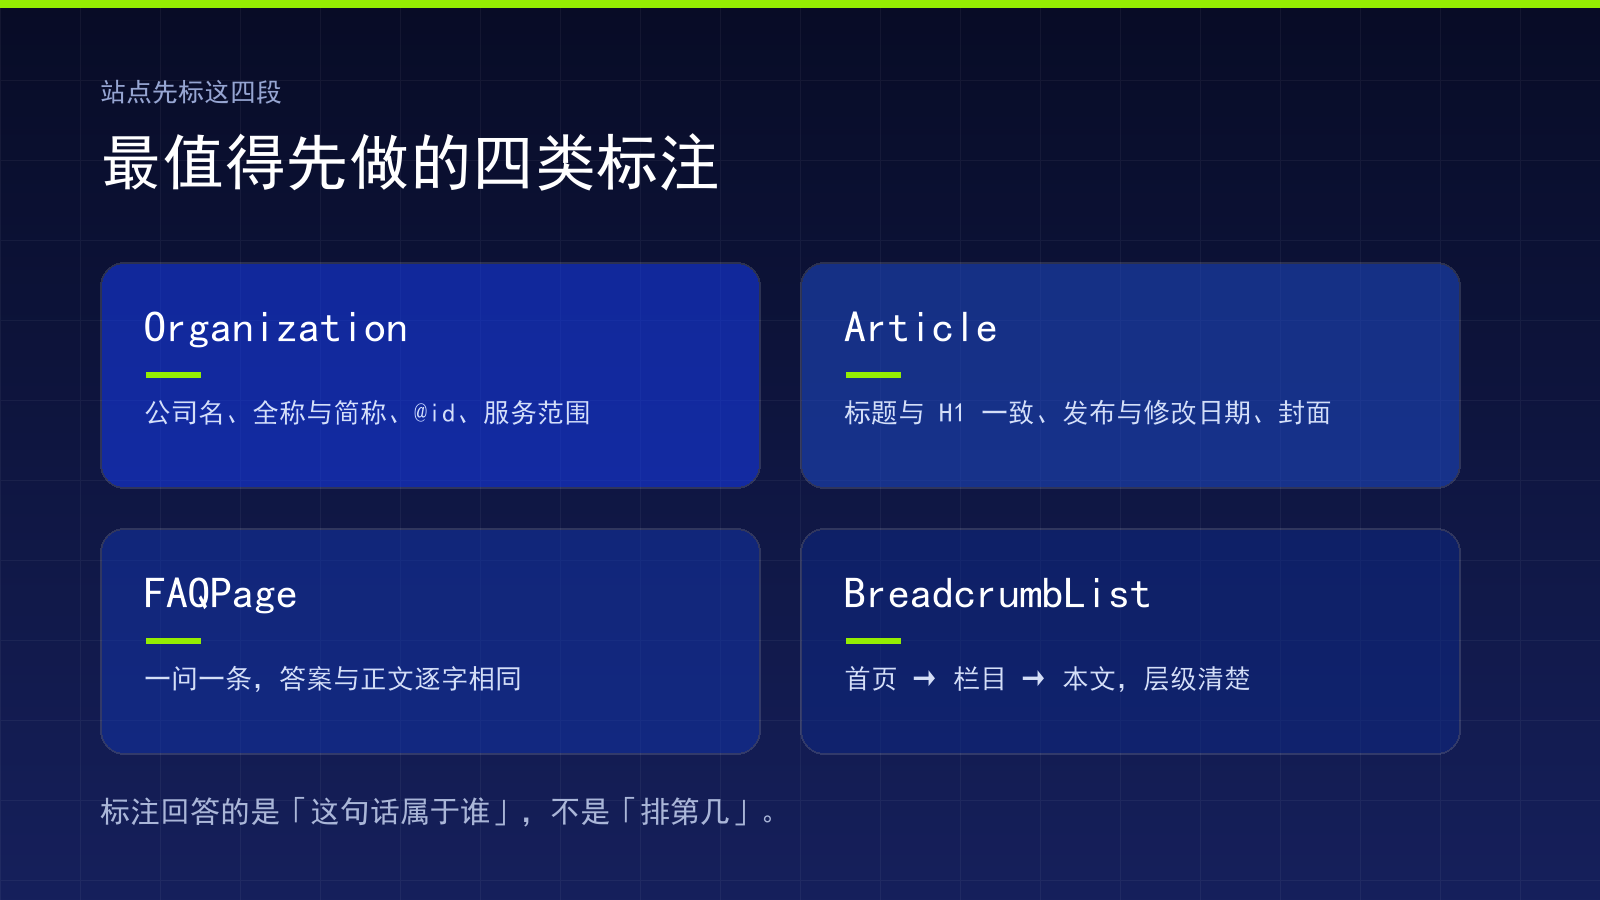
Organization:把公司名钉成一个实体
name 用工商全称,alternateName 放日常简称,@id 固定成一个地址(例如站点域名加 #organization),全站复用同一个值。url、logo、telephone 必须与页脚逐字一致——页脚写的是哪串号码,标注里就写哪串。服务范围用 areaServed 如实写:我们写“以京津冀为中心、辐射全国”,因为这就是实际接单范围;写窄了会挡掉外地客户,写虚了又过不了核验,两头都不划算。
这里最容易被忽略的是 @id。它相当于实体在互联网上的身份证号,一旦定了就不该每页不同。同一家公司在几十个页面里被标成几十个不同实体,等于自己把权威性拆成了碎片。
Article:让每篇文章有明确身份
headline 与页面 H1 逐字一致,不要一个写营销标题、一个写栏目名;datePublished 与 dateModified 分开写,内容改过就更新后者;image 指向真实存在的封面文件,而不是一个占位路径。这三项是判断“新旧”和“是否原创”最直接的依据,也最容易被随手写错。
FAQPage:一问一条,逐字对应
每条 Question 的 name 就该是客户的原话问法,acceptedAnswer 的 text 与页面可见答案一字不差。不要把一条长答案硬拆成三个问题,也不要把与这一页无关的通用问题塞进来——FAQ 标注只对“这一页真的回答了这些问”成立。这一条与把官网改造成问答站是同一件事的两面:结构对了,内容才有落点。
BreadcrumbList:说清这一页在站内的位置
首页 → 栏目 → 本文,层级写清楚,position 连续。它本身不带来流量,但能让检索侧看出“这个站点在某个主题上有成体系的覆盖”,也让答案摘录时能带上来源路径。层级混乱的站点,往往连栏目页都被当成孤立页面。
三、五个高频错误
- 标注与正文两处手改。改了正文忘了标注,页面上一套说法、标注里一套说法。检索侧读到两份不一致的信息,通常两份都不采信。
- @id 每页不一样。模板里带了一段随机值,或者每页复制粘贴后忘了改。结果是同一家公司在数据层被拆成多个实体。
- 名称三套写法。页脚全称、关于页简称、标注里又是品牌名。实体消歧失败,权威性被打散,这是最隐蔽也最普遍的一种。
- 把 FAQ 标注当装饰。为了“看起来结构化”,每页都塞同一组通用问题,结果没有任何一页真的回答了它们。
- 只标不写。正文是一大段没有层次的介绍,标注却填得很热闹。检索按段落切块,切不出能回答问题的块,标注只是空壳。
四、可照做的做法:一份数据,两处输出
上面五个错误里,前三个的根因是同一个:同一个事实被维护了两遍。只要有两处手写的副本,就一定会分叉。解决办法不是“记得同步”,而是让它们没有分叉的机会。
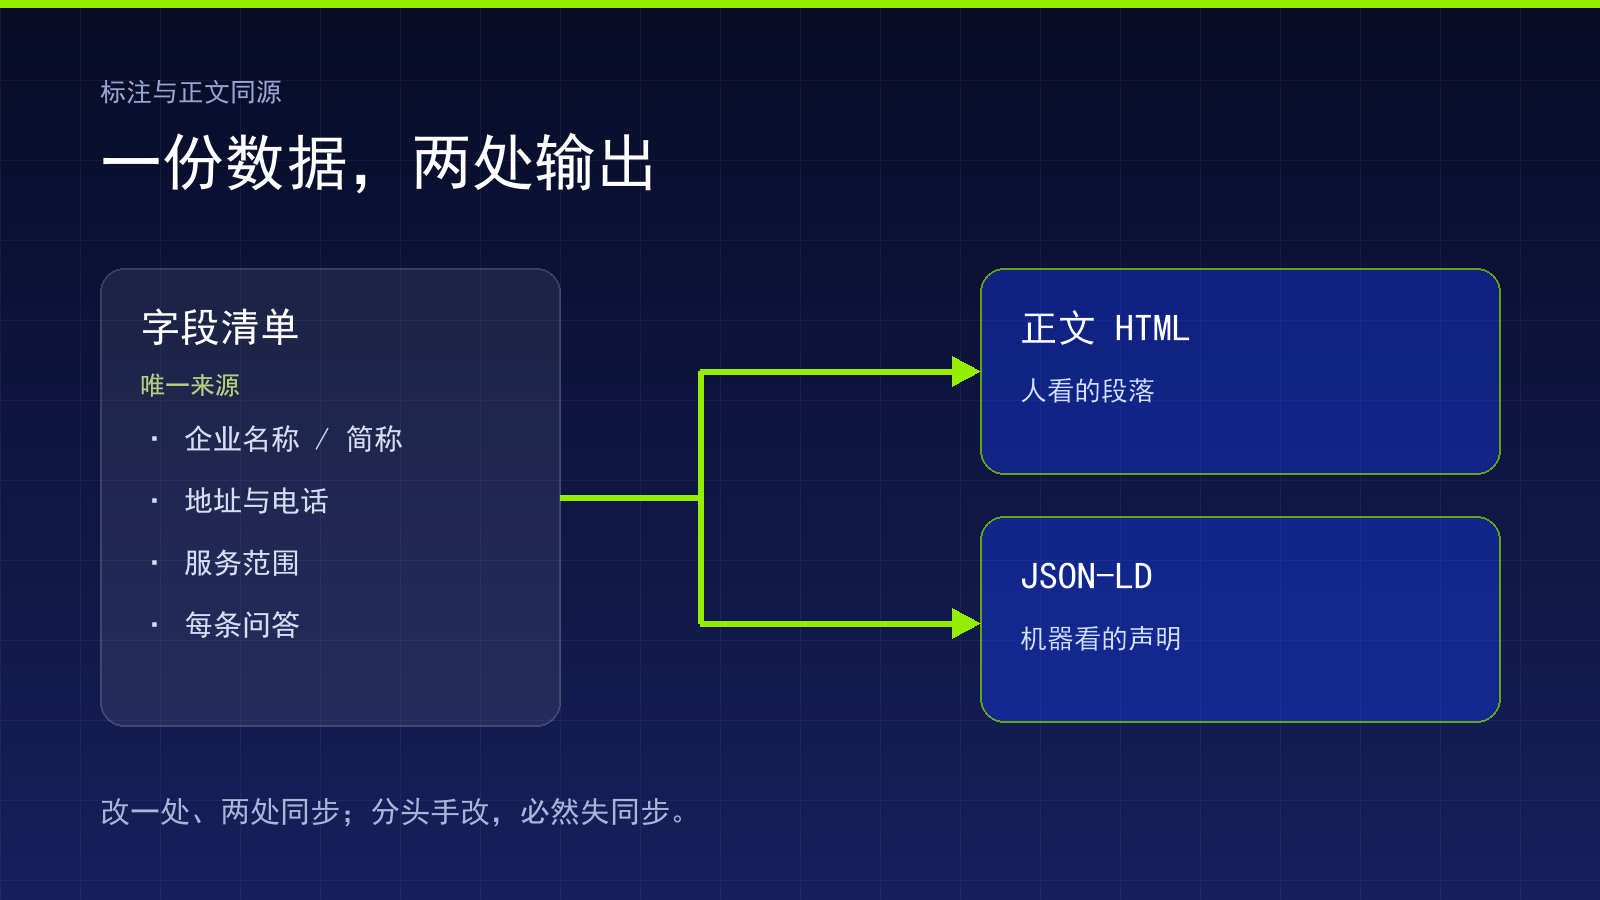
具体做法不复杂,三步就能跑起来:
- 建清单。把企业名称、简称、地址、电话、服务范围、每条问答写成字段(一个 JSON 文件或一张表都可以),同一个事实只允许出现一次。
- 生成两处。页面正文由清单渲染,
ld+json也由清单渲染,中间不经过任何手工转录。转录就是分叉的起点。 - 改版核对。任何一次改文案,先改清单,再重新生成;发布前用脚本把问答的文本与页面可见文本比对一遍,不一致就不发。
如果站点是纯手工维护的静态页,做不到自动渲染,那就退一步守住一条底线:改正文和改标注必须在同一次提交里完成,不要留到“下次一起改”。留到下次,通常就没有下次了。
五、上线前的五项自查
这些检查不需要任何付费工具账号,浏览器加上几行脚本就能做完,每次改版前后各跑一遍。
- 看源代码,不是审查元素。审查元素看到的是浏览器执行脚本之后的结果,查看源代码看到的才是爬虫拿到的 HTML。标注不在原始 HTML 里,等于没标。
- 逐段解析。把每一段
ld+json的内容单独取出来做一次 JSON 解析,语法错一个逗号,整段失效,而且页面上完全看不出来。 - 比文本。把 FAQ 里每个答案与页面可见答案做字符串比对,差一个标点都算不一致,改到一致为止。
- 查重复。全站搜索
@id,确认同一个实体只有一个值,并且这个值在所有页面里都指向同一个地址。 - 看日期。
dateModified是否等于这次真实修改的日期。为了“看起来新”而改日期,短期看不出问题,长期会让整个站点的时效信号失真。
六、两个常见问题
- 加了结构化数据,AI 就会推荐我的网站吗?
- 不会。结构化数据只负责把“这段话属于哪个实体、回答的是哪个问题”说清楚,它不生产内容,也不改变平台排序。页面正文里没有可被切块的段落,标注写得再全也换不来一次引用。
- 标注错了会有什么后果?
- 最直接的后果是整段标注被忽略。语法错一个逗号、标注文本与正文对不上、同一个实体每页换一个 @id,都会让检索侧无法确认真实信息,倾向于以正文为准或不采信。
顺带说一个判断口径:如果你看到有人承诺“加上结构化数据,AI 引用率提升多少倍”,那不是技术结论,是销售话术。平台算法不公开、且持续变动,任何量化承诺都不成立。能核对的只有交付物本身——标注是否完整、是否与正文同源、改版后是否仍然成立。
文中方法为本团队实践总结,不含虚构实测数据与客户案例;引用行业数据均标注口径,请以原始来源为准。我们不承诺特定平台的推荐结果——AI 平台算法不公开且持续变化,我们做的是持续优化与用数据观察趋势。