这件事有一个很实用的推论:你没能力让所有 AI 说同一句话,但你有能力让它们读到的底稿是同一份。前者做不到,后者做得到。而且做完之后,差异会从“事实打架”退化成“措辞不同”——后者无害,前者要命。
一、先把两件事分开:生成差异与检索差异
看到几个平台的答案不一样,先别急着改页面。这两类差异混在一起看,会得出完全错误的结论。
一类是生成差异。同样的材料,不同模型会组织成不同的话——长一点、短一点,先讲结论还是先讲背景。这类差异属于风格,不影响客户的判断,也不值得投入。你在它身上使再大的劲,客户能感知到的变化也接近于零。
另一类是检索差异。不同平台在回答之前,检索到的材料本身就不一样:有的读到了你的官网正文,有的只读到一条几年前招商页上的简介,有的读到的全是竞品的行业稿。这才是真正要处理的那一层。
区分方法非常土,但有效:把同一个问题的几个答案并排放,只挑“事实句”来看——公司叫什么、在哪、做什么、服务谁、有什么资质、是自研还是授权。事实句一致、只是组织方式不同,属生成差异,放过;事实句互相打架,属检索差异,必须处理。这一条判断标准,比任何工具报表都可靠。
二、差异来自三层,一层比一层可控
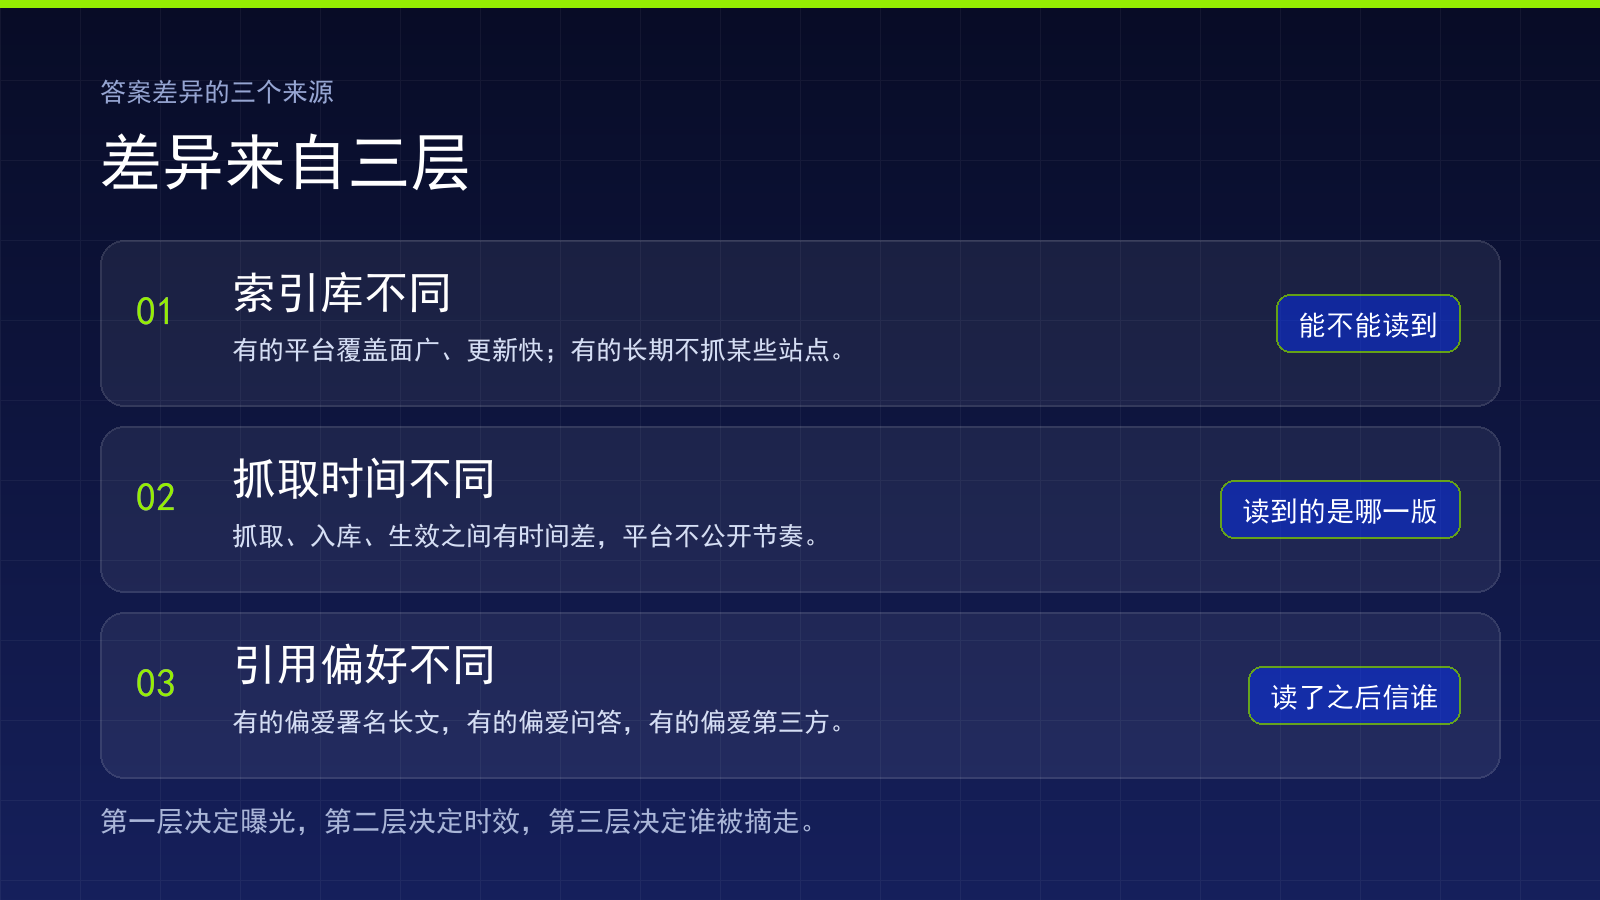
第一层:索引库不同——能不能读到。每个平台背后能读到的网页集合并不相同。有的覆盖面广、更新快,新发的文章几周内就能被读到;有的对某些站点抓得很浅,甚至长期不去抓。结果是:你官网上写得清清楚楚的一句话,在某个平台那里从来没被读到过。它不是不认可你,是没见过你。这一层的对策只有一个字:铺——把同一份事实放到多个它确实会读的地方去,而不是在自家页面上反复加粗。
第二层:抓取与缓存的时间不同——读到的是哪一版。同一个平台,今天的答案和三个月前也可能不一样,因为期间它的索引更新过。这也解释了为什么“官网改完第二天去问,答案没变”是常态:抓取、入库、生效之间存在时间差,具体节奏平台不公开,实践中通常按周甚至按月计。所以改版之后当天问一次就下结论,是最常见的误判来源。
第三层:引用偏好不同——读了之后信谁。面对同一批候选材料,不同平台倾向采信的类型确实有差别:有的偏爱有明确署名、有日期的长文;有的偏爱结构清楚的问答;有的偏爱被反复转载过的第三方页面。这一层最像“平台性格”,但它仍然是可观察、可归纳的——因为你看到的是结果,而结果里往往带着来源。
三、一张对照表:五问三平台,两天能做完
想知道自己的品类在哪个平台、被哪些信源“代言”,不用买任何工具,一张表就够。做法是这样:
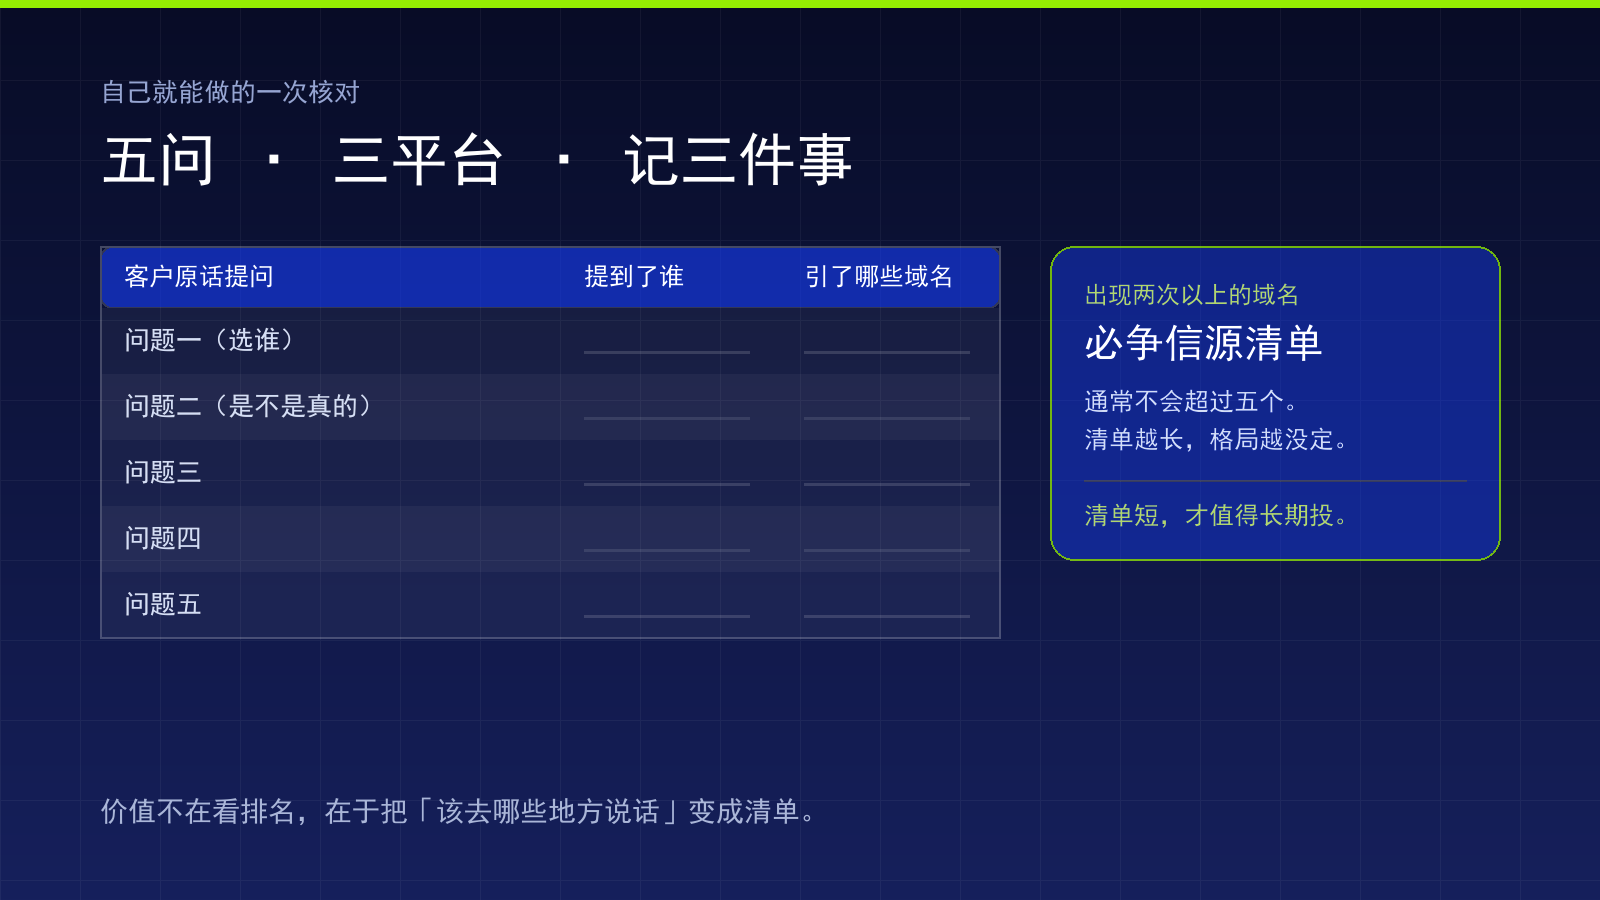
- 定五个问题。用客户的原话,别用行业术语。至少覆盖两类:一类是“选谁”(例如“某某设备哪家做得好”),一类是“是不是真的”(例如“某某公司靠不靠谱”“这种工艺能不能做”)。后一类问题往往比前一类更能暴露事实分叉。
- 定三个平台。选你客户真在用的,不选你觉得高级的。多数行业里客户常用的就两三个,多测无益。
- 逐条记三件事。答案里提到了哪些公司名;答案列出或嵌入了哪些来源域名;答案里关于你的每一条事实,与你官网是否一致。
- 统计域名。把三个平台里出现两次及以上的域名圈出来——这就是你这个品类的“必争信源”,通常不会超过五个。清单越短越可信,长到十几条的清单,等于没有清单。
- 逐条核查。这五个信源上,实体名称有没有全称与简称混用;页面上有没有一句能被直接摘走的完整事实句;更新日期是否在十二个月内。三项里挂两项的,就是该优先修的地方。
这张表的价值不在“看排名”,而在于把“我该去哪些地方说话”从猜测变成清单。做完一次之后按季度重跑,观察清单是否稳定——只有稳定的清单才值得当作长期投入的方向;每次跑出来都不一样的,说明这个品类还没有稳定的信源格局,此时更该先把自家事实做扎实。
四、什么必须统一,什么可以不一样
这是最容易被做过头的地方。有人发现各平台说法不一致,就想把所有平台的表述统一成一个模板。这既做不到,也没必要。
必须统一的只有“事实层”:工商全称与对外简称的对应关系;所在地(写具体城市,不写“华北某地”“京津冀一带”这种模糊表述);主营业务的一句话定义;资质与授权的真实状态;联系方式。这几项在任何一处出现分叉,都会被判成“信息不可靠”,代价远大于措辞不统一。
可以不一样的是“表述层”:同一件事的详略、举例、顺序、语气。专业客户要看参数,本地客户要看场景,同一个事实用两种讲法,是适配而不是矛盾。把表述层也强行统一,会写出一堆谁都不想看的中性废话——那反而降低了被引用的概率。
有一条要单独说清楚:技术归属必须写准。引擎底座是授权还是自研、系统是集成还是自建,这类信息一旦在不同页面出现两种说法,是最容易被检索侧判为不可信的——因为它是可以被外部核对的硬事实,而不是表达上的选择。我们自己的内容在这件事上有一条固定规则:自研的部分写自研,授权的部分写授权,且在每一处出现时都保持一致。
五、这套方法的三个失效边界
方法有边界,讲清楚比讲漂亮有用。
- 品类本身几乎没有检索行为。如果客户找供应商靠的是熟人介绍、展会、协会名录,AI 搜索这一层的水量本来就小,信源建设的边际收益会很低。先确认需求端真的在问,再决定投多少。这不是方法的问题,是选错了战场。
- 平台不显示来源。有些产品的答案不列引用,只能从“这句话的说法”反推它读了什么,精度会明显下降。这种情况下,对照表要从“域名统计”退化成“事实一致性核对”——仍然有用,但推不出必争清单。
- 覆盖信源不等于被引用。进了必争信源只是必要条件。同一页面上可能并列着十家同行,谁被摘走,取决于那一段写得是否完整、是否可核对、是否给出了明确结论。信源是入场券,不是座位。
再补一句诚实的:这套方法能改善的是“被读到的概率”和“读到之后不出错”。它不能承诺任何平台一定提到你,也不能承诺提到之后一定带来询盘。任何把这两件事打包承诺的说法,都不是技术结论,是销售话术。
六、两个常见问题
- 不同平台答案不一样,是不是说明 GEO 做失败了?
- 不是。先看事实句是否一致:公司名称、所在地、主营业务、资质状态这几项如果各平台说法相同,只是详略和顺序不同,那属于正常的平台差异。真正的失败信号是事实打架——一个平台说你在 A 地,另一个说在 B 地;一个说你是授权服务商,另一个说你是生产厂家。判断顺序永远是先事实、后措辞。
- 要不要给每个平台单独准备一套内容?
- 不必。先做准一份事实底稿,再按平台的内容形态改写,长文、问答、图文各一版就够。为每个平台单独造一套事实,等于自己制造分叉,而分叉一旦出现,检索侧通常两份都不采信。内容形态可以不同,事实不能不同。
文中方法为本团队实践总结,不含虚构实测数据与客户案例;引用行业数据均标注口径,请以原始来源为准。我们不承诺特定平台的推荐结果——AI 平台算法不公开且持续变化,我们做的是持续优化与用数据观察趋势。