同一个事实写了五遍,AI 只认一遍——重复不产生权重
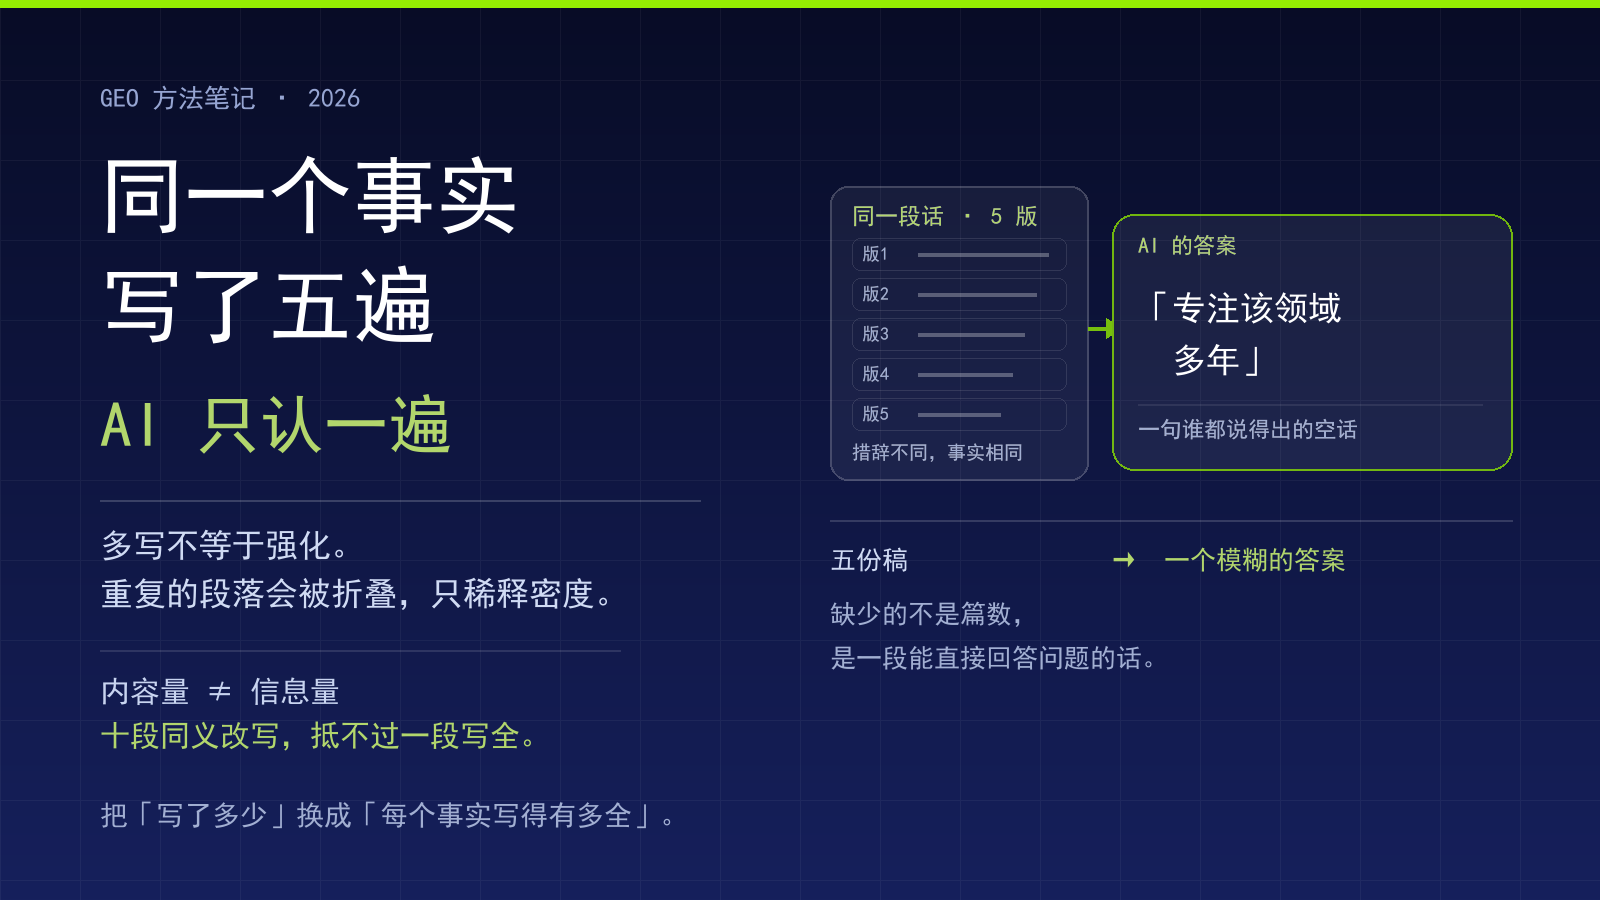
三年写了二十几篇稿,客户在 AI 里问一个具体问题,答案里还是那句「专注该领域多年」。 问题多半不在数量,在于同一个事实被写了五遍,每一遍都只说了半句。
一、先看现象:写得越多,能被引用的反而越少
一个很典型的场景。企业三年里陆续写了二十几篇内容:官网八个页面各有一段公司介绍,公众号发过三版品牌故事, 百家号和知乎上是同一篇稿的改写,每次改版又重写一次简介。措辞都不完全相同,但说的都是同一件事—— 我们是谁、做了多久、服务过哪些行业。
结果客户在 AI 里问一个很具体的问题:「这类设备交期一般多久」,答案里出现的还是那句「该公司专注该领域多年」。 不是 AI 没读到你的内容,是读到的每一块都只说了半句。
这里面有个普遍的误判:把「内容量」当成「信息量」。字数、篇数、平台数都在涨,但可被摘录的完整答案没有增加。 AI 要的是一段能直接回答问题的话,而不是十个角度重复的表态。
还有一个更隐蔽的代价。重复不是免费的——它占用了本可以用来写细节的篇幅, 也占用了检索侧分配给一个站点的候选位置。位置是有限的,被近似页占掉一个,就少一个。
二、机制:检索切块之后,相似块会被折叠
要理解为什么重复不生效,得先看清检索这一步在做什么。
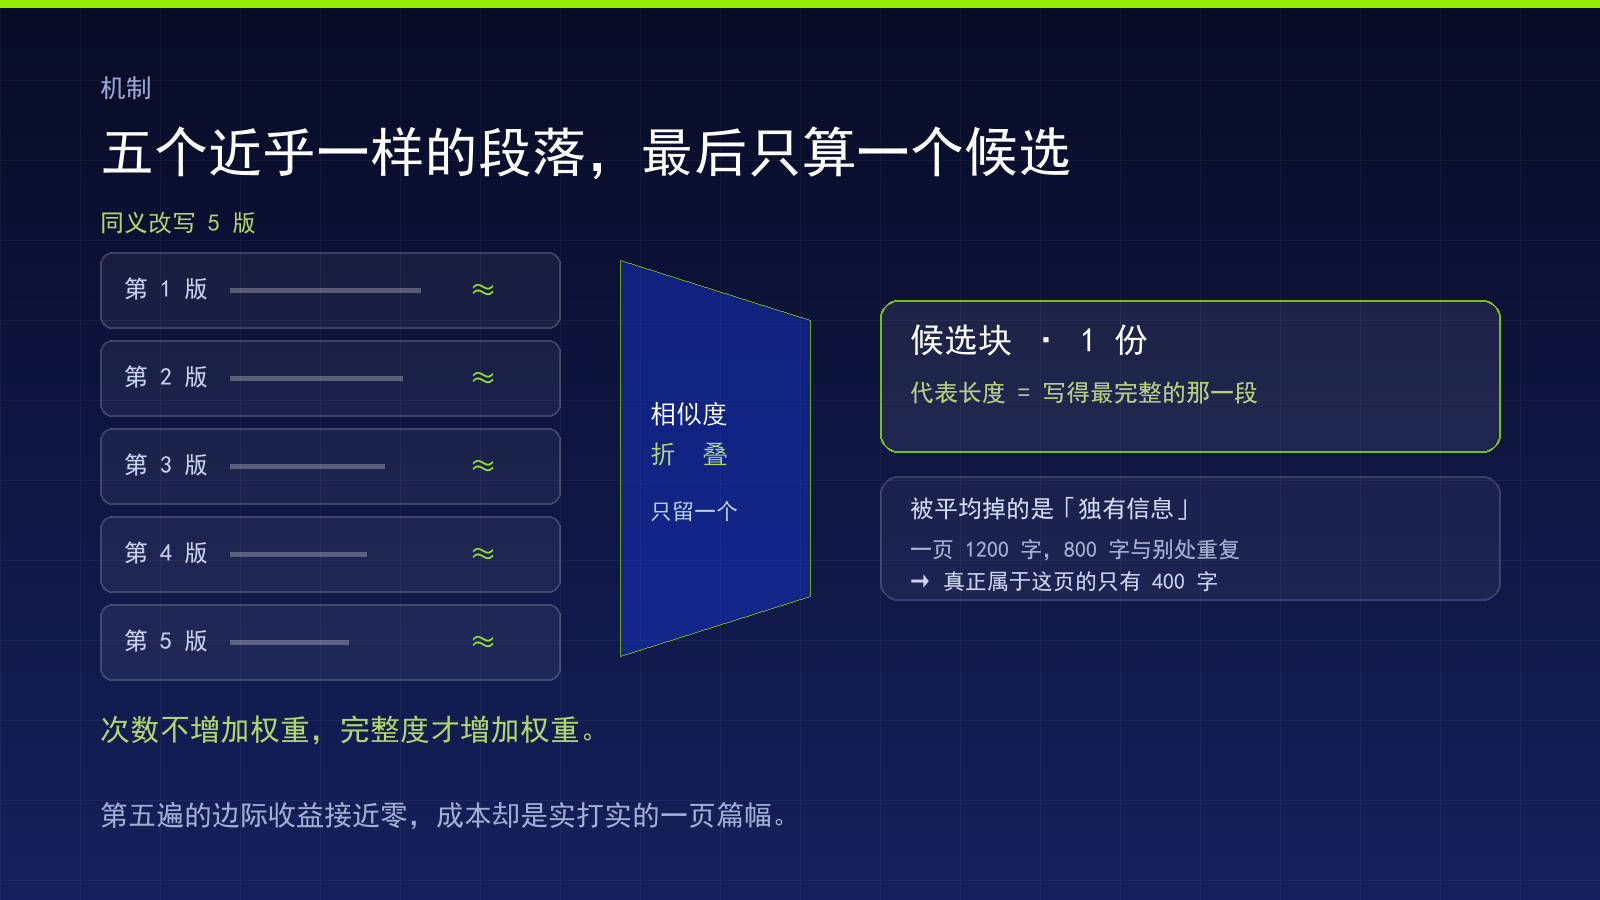
现在主流的 AI 搜索多是检索增强生成:先抓取公开网页,把正文切成语义块,为每个块建索引; 用户提问时先召回一批相关块,再重排,最后用排在前面的块组织答案并标注来源。这条链路上,重复内容会遇到两道处理。
第一道:近似重复折叠。索引与召回阶段普遍会对高度相似的块做合并或降权(公开口径,待核验)。 原因很朴素——同一个问题给十个几乎一样的候选,对组织答案没有帮助。折叠之后,这一组块只保留一个代表, 代表性由「写得最完整的那一块」决定,而不是由「出现次数」决定。
第二道:信息密度被摊薄。一页 1200 字,其中 800 字和站内其他页面重复,这页的独有信息只有 400 字。 重排阶段比的是「谁更完整地回答了这个问题」,独有信息少的那一页天然排在后面。
把这两道合起来看,结论很直接:重复不叠加权重,只稀释密度。你写第五遍的时候, 边际收益已经接近于零,而成本是实实在在的——占掉了一个页面本可以承载的细节。
这也解释了一个常见困惑:为什么有的企业站页面不多,却经常被引用。因为它的每一页都在回答一个不同的问题, 没有一页是另一页的改写。
三、关键区分:同站重复是负担,跨站重复是印证
说到这里容易走偏,得出「重复都不好」的结论。这是错的。重复要看发生在哪里。
同站重复是负担。同一个域名下多个 URL 说同一件事,检索侧会判断为近似重复,往往只保留其中一个进入候选, 其余页面实质上被浪费。更麻烦的是,你的导航、内链、sitemap 还在给这些近似页分散入口—— 本该集中到一页的信号,被摊到八个页面上。
跨站重复是印证。不同域名、不同主体在说同一组事实——公司全称、注册地址、成立时间、主营品类、资质—— 这是可信度信号。AI 判断一个事实是否成立,很大程度看它在几个独立来源里被一致地提到。 这里的一致,指的是事实一致,不是文案一致。
所以正确的方向不是「少写」,而是「同站收敛、跨站扩散」。同站把事实收进一页写全, 跨站把这一组事实铺到行业协会、B2B 平台、行业媒体、问答社区去。
有个细节要注意:跨站要铺的是事实,不是整段文案。整段照搬容易被判为转载或采集,独立来源的价值会打折; 而「名称 + 地址 + 主营 + 资质」这类结构化事实,在多处一致出现才是加分项。
四、动作:权威页 + 卫星页,一个事实只住一个地址
具体怎么改,用一个结构就能说清:权威页 + 卫星页。
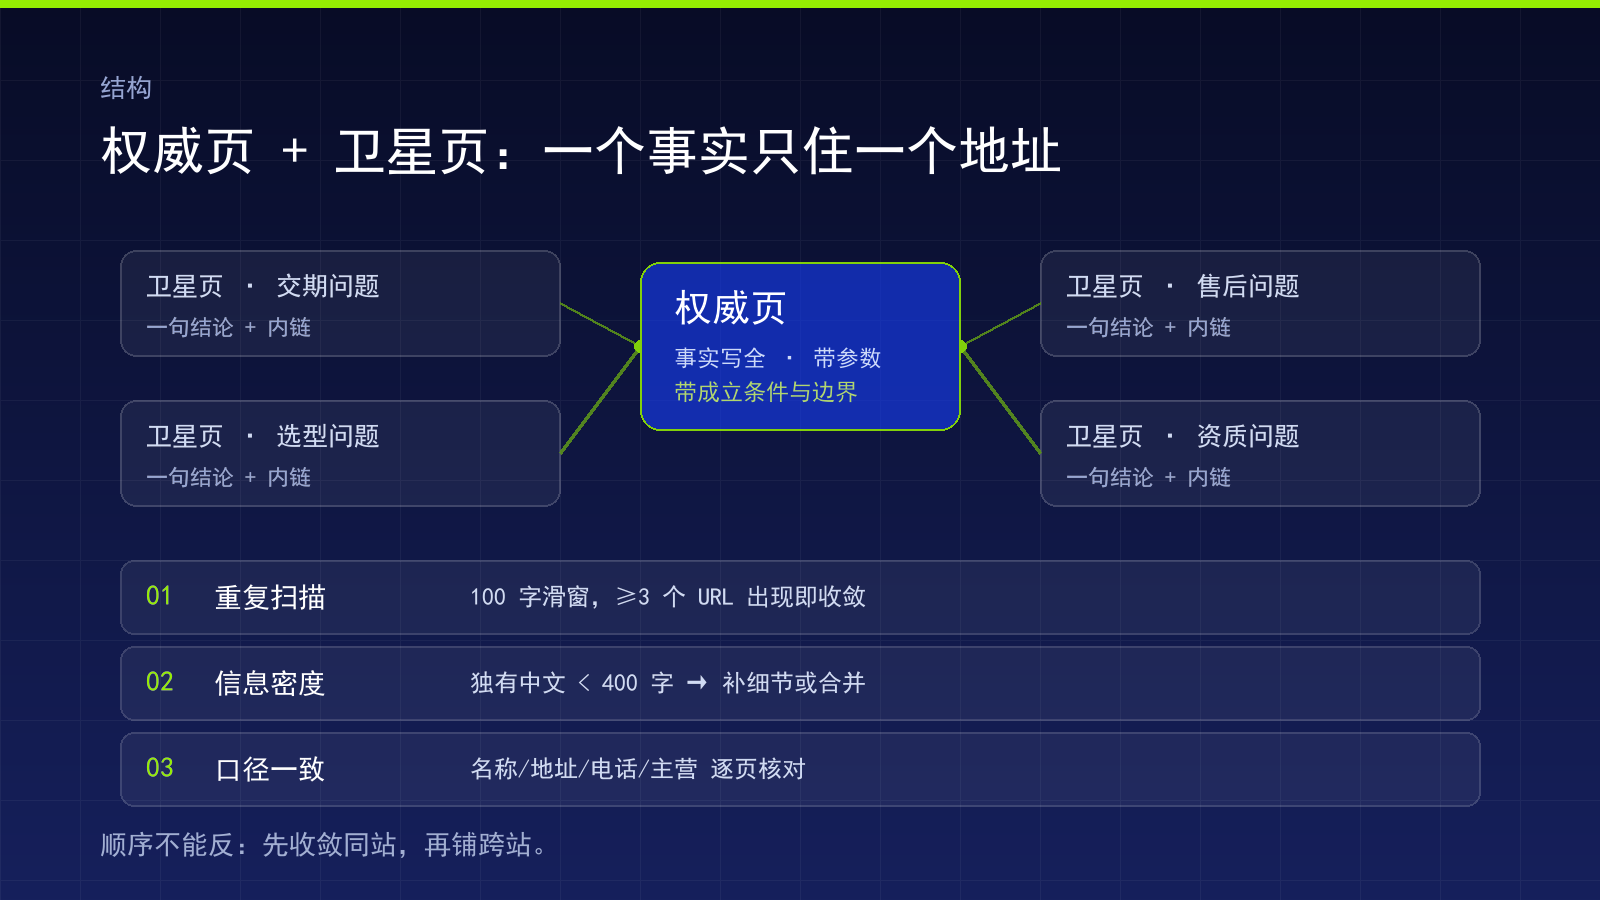
一个事实只在一个 URL 写全,这一页叫权威页;其他需要提到这个事实的页面, 只写一到两句结论,然后链过去,这些叫卫星页。卫星页不是复制品,它回答的是另一个问题, 只是借用了权威页的结论。
第一步,列事实清单。把客户会反复问的事实列出来:成立时间、主营品类、产能或规模、交付周期、 服务区域、资质证书、售后范围。每一个事实指定唯一一个权威页。一个事实只能有一个家。
第二步,拆现有页面。把卫星页里的重复段落删掉,换成一句结论加一个内链。删之前先检查: 这段重复文字里有没有别处没有的细节——具体参数、具体流程、具体案例的成立条件。有的话,把细节上移到权威页, 不要一起删掉。这一步最容易出错的地方,是把独有细节当成重复删了。
第三步,改权威页的标题与首段。标题用客户的原话问句,不要用「服务说明」「产品概述」这类内部命名。 首段 40–60 字给完整结论,把数字写进去——「50 件起订」而不是「少量起订」,「7 个工作日」而不是「尽快」。 AI 摘录的是能直接回答问题的句子,模糊表述摘不出东西。
第四步,新增内容前先查。写新稿前先问一句:这个事实有没有权威页? 有就链过去,写新角度而不是重写事实;没有才新建。这条规则坚持三个月,站内的近似页会自然收敛。
改稿前的三道自查,都带参数。
自查一,重复段落扫描。抽 10 个页面,把正文按 100 字滑窗切片,两两比较重合度; 同一段落出现在 3 个以上 URL,就列为待收敛项。3 这个阈值是经验值,不是行业标准, 目的是把工作量控制在可执行范围内。
自查二,信息密度。单页去掉与站内其他页面重复的内容后,剩余独有中文字数低于 400 字, 这页大概率进不了候选——要么补细节,要么合并进权威页。删完发现确实没剩什么, 说明它本来就该合并,而不是留着凑数。
自查三,口径一致性。把名称、地址、电话、成立时间、主营描述拉成一张表,逐页核对。 一个字段出现三种写法,在 AI 眼里就是三个不同的主体,前面两步的收敛会白做。
顺序不能反:先收敛同站,再铺跨站。同站还散着的时候去铺跨站,等于把混乱放大到更多地方。
五、边界:这套改法在三种情况下不管用
方法有适用条件,说清楚比说好听有用。
一是单页型站点。只有一个落地页、没有内容体系的企业,谈不上同站重复,问题在信息太少。 这种情况该做的是补内容,不是收敛。先有十来页回答不同问题的页面,才轮到谈去重。
二是强时效内容。政策解读、行情快讯、活动通知,旧稿的价值就在「当时」,不该合并进常青的权威页。 这类内容要用日期和版本号区分,页面上明确标注是哪一版,让读者和检索都能判断新旧。
三是多主体、多区域的独立站。如果是为了不同区域刻意做的独立站,页面相似是有意为之, 此时该做的是主体关系标注——写清是同一集团下的哪个主体、服务哪个区域,而不是删内容。 删了反而让客户分不清谁是谁。
还有一条要诚实说:去重与折叠的具体规则,各平台都不公开,也在持续调整。 本文讲的是方向性判断,不是可验证的算法细节。任何声称「知道平台去重阈值」的说法,都欠核验。
周期上也不要有幻想。页面重新被抓取通常 2–4 周,候选集出现变化 4–12 周,稳定体现在询盘上多在 60–90 天。 我们不做排名承诺,也不承诺「保证被 AI 推荐」——平台算法不公开且持续变动,这样的承诺站不住。 能承诺的是动作清单、交付基线和每月复测数据,过程可查。
六、三个常见问题
- 同一篇文章发到多个平台,算重复内容吗?会影响效果吗?
- 跨平台分发本身不是主要问题,因为重复的是文案,不是事实。要注意两点:整段照搬容易被判为转载或采集,作为独立来源的价值会打折;各平台页面上的主体信息(公司名、地址、主营)必须一致,这一致性反而是加分项。真正的风险不在「发多次」,而在「发多次但每次主体信息都不一样」。
- 把重复段落删掉,页面会不会变薄,反而不利于收录?
- 页面会变短,但不等于变薄。判断标准是独有信息量,不是字数。删掉的是与站内别处重复的段落,保留并补强的是别处没有的细节,后者才是能被检索命中的部分。如果删完发现确实没剩什么,说明这一页本来就该合并进权威页,而不是留着凑数。
- 怎么判断哪些段落属于重复,需要收敛?
- 按「是否回答同一个问题」来判断,不按「措辞是否一样」。两段话措辞完全不同但都在回答「产能多少」,就属于重复;措辞和别处一样但在回答另一个问题,可以保留。最省事的做法是先列一张问题清单,再看每个问题有几个页面在答,答同一问题的超过三个就可以开始收敛。